在前面的文章中,我們已經介紹了電腦和手機上的螢幕閱讀器 (Screen reader),它可說是視障者探索數位世界的橋樑。透過螢幕閱讀器,視障者可以處理文書、上網搜尋資料、經營社群媒體等等,在學習、就業和生活中都獲得了莫大的幫助。
參考文章:
然而,螢幕閱讀器的主要功能是獲取物件上的文字資訊並將其轉換成語音或點字。當遇到物件不含文字資訊時,例如物件為圖片且該圖片沒有加上替代文字,螢幕閱讀器將無法傳達資訊給使用者。換句話說,如果螢幕閱讀器沒有搭配圖像辨識工具,視障者幾乎無法僅靠螢幕閱讀器了解圖片內容。而在生活中,視障者難免會遇到圖像訊息,試想,當視障者收到一份紙本信件時,要如何閱讀信件上的內容?當朋友分享一張照片時,視障者要如何知道照片中包含了哪些資訊呢?
今天,我們將深入探討圖像辨識技術,從文字辨識到物件辨識,再到利用 AI 進行圖片理解,帶領大家領略科技是如何幫助視障者了解圖像的內容。
文字辨識,又稱光學字元辨識 (optical character recognition,簡稱 OCR),是圖像辨識技術中最為基礎的一環。透過 OCR 技術,我們可以將印刷文字,甚至手寫文字直接掃描辨識出來,並轉換為可供螢幕閱讀器朗讀的文字檔。
而一直以來,視障學生在面對缺乏電子檔教材時,也同樣仰賴 OCR 來轉換紙本的教材,再經由師長或親友進行校對,提供學生閱讀和學習,因此 OCR 的辨識準確度和效率就成了一大關鍵。
如今,OCR 技術已經廣泛整合於各類螢幕閱讀器之中,如電腦上的 NVDA,手機上的旁白及 TalkBack 等,當遇到有文字的圖片時,螢幕閱讀器會嘗試進行 OCR 並將結果讀出來。此外若不使用螢幕閱讀器所提供的 OCR,許多應用程式也有類似的功能,同樣能幫上忙,例如 Line、Google 文件等。筆者有時就會使用 Line 內建的 OCR 功能,將菜單上的文字抓出來閱讀。如果你平常需要透過拍照並在事後作一些文字筆記,不妨將此技巧學起來,將能夠讓你在抓取影像中的文字更有效率。
參考資料:
如何擷取圖片上的文字?LINE隱藏小技巧讓你一鍵搞定- SOGI 手機王
面對形形色色的圖片及照片,能夠辨識文字當然還不夠,因而有了物件辨識的技術,顧名思義就是能夠將圖片中有哪些物件辨識出來的應用,例如房屋、樹木、動物、食物等,甚至可以識別人物的年齡、性別、服裝等特徵。
大約在 1960 年代,隨著電腦技術的發展並在文字辨識的基礎上,物件辨識也漸漸發展起來,當時主要是透過手工特徵提取,例如物件的形狀、顏色和紋理。到了 2000 年代,深度學習技術的興起為物件辨識技術帶來了重大突破。深度學習模型可以自動學習圖像中的特徵,從而提高物件辨識的準確度。
例如 Facebook 這類社群媒體平台,會在圖片沒有替代文字時自動加上物件辨識結果作為替代文字。因此螢幕閱讀器瀏覽到這些圖片時,就能讀到辨識出的物體,像是「可能是壽司、生魚片和肉排的圖像」、「可能是 2 個人、街道、樹和文字的圖像」。
而現今物件辨識被廣泛運用於各種領域,例如圖像搜尋可以讓我們快速找到想要的商品、用於醫療協助醫師判斷病理影像、用於人臉辨識協助找到犯罪者、甚至在自動駕駛、智慧家庭等等都是不可或缺的重要技術。你也可以想一想在生活中是否曾經需要用到物件辨識,或無意中受惠於物件辨識的技術呢?
參考閱讀:
從上述 Facebook 所舉的例子,雖然可以讓視障者了解照片中可能有哪些物件,但是你可能會發現光是物件辨識能難以完整且精確的將圖片中的資訊傳達給使用者,例如食物中有哪些食材、人像的表情、穿著、動作等等細節的描述。
受益於近期生成式 AI (Generative AI) 的快速發展,辨識圖片的能力也有了大幅的進步。我們直接來看一個範例,你也可以試著直接上傳一張圖片給 Chat GPT 或 Gemini,讓它描述圖片中的內容。
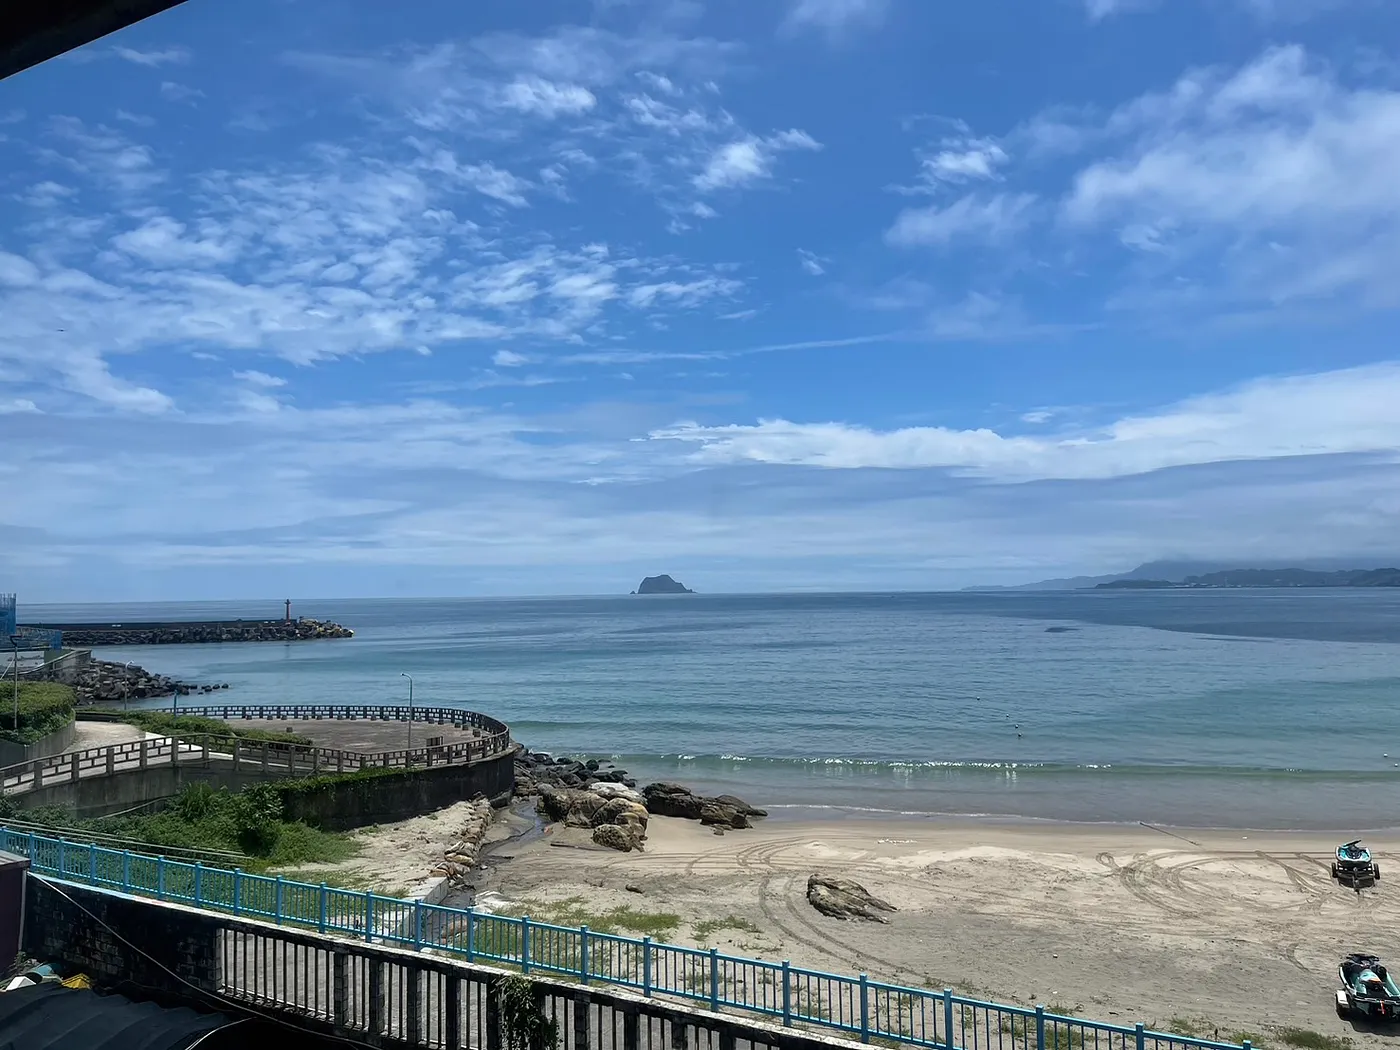
AI 的描述:這張照片展示了一個美麗的海灘景色。前景是一片沙灘,沙灘上有一些岩石和車輛的輪胎痕跡。沙灘旁邊有一條藍色欄杆的步道,步道旁邊有一些綠色植物。中景是平靜的海面,海水呈現出淡藍色,遠處可以看到一個小島。背景是藍天白雲,天空中有一些散落的雲朵,天氣看起來非常晴朗。整體感覺非常寧靜和美麗。
當視障者聽到上述的 AI 描述,就能更生動地想像照片中的畫面以及可能想要傳達的意境。而除了描述圖片之外,透過對話,我們還可以進一步詢問詳細資訊,例如拍攝的可能地點、人們穿著的顏色、表情、圖像中偵測到的文字等等。
問:這張照片可能拍攝的地點?
答:這張照片可能是在台灣的東北角拍攝的,特別是像基隆或宜蘭的海岸線。照片中的小島看起來像是基隆嶼,這是一個位於基隆外海的小島。這些地區以其美麗的海景和寧靜的環境而聞名。
生活中常見的應用
那麼這麼方便且強大的圖像辨識技術,究竟帶給視障者在生活中哪些便利呢?以下我們來看看筆者自己或他人的使用經驗:
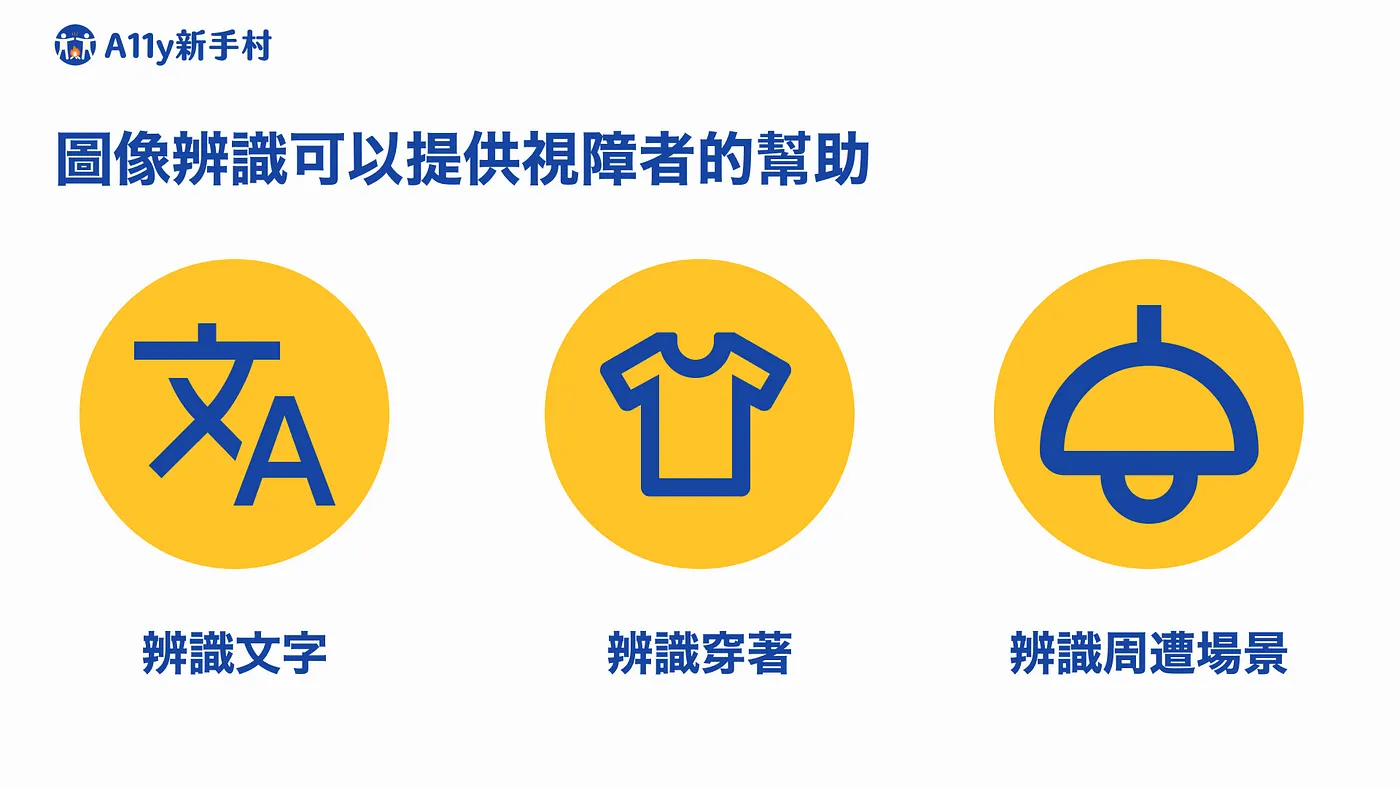
1. 辨識文字:
生活周遭我們常常會需要查看印有文字資訊的物體的情境,此時圖像辨識就能派上用場。,例如筆者就會使用 AI 來辨識手上的食物或飲料包裝,了解其口味與成份或是有效日期等資訊。其他像是確認冷氣搖控器上的溫度及設定,查閱收到的廣告或紙本信件、藥單上的說明等等。此外,筆者在外出用餐時,也會利用相機來拍攝菜單,再利用 OCR 或 AI 來描述菜單內有哪些餐點,這樣就能一邊讀一邊決定要吃什麼了。
隔壁早餐菜單的例子
![超時間三明治/漢堡菜單,含17項品項,價格從60元到110元不等,附單點及A、B、C加購欄位供勾選。][一張菜單,作為AI辨識的範例圖片。
AI提供的描述如下:
這是一張菜單,標題是「趁時簡三明治/蒸堡 (含3片吐司・生蛋)」。菜單列出了各種三明治和蒸堡的名稱及價格,並有三個選項欄位(A、B、C)供選擇。以下是菜單上的項目及其價格:
夏威夷風帕里帕里雞G 🌶️ — 110元
日式叉燒柚子胡椒QP醬 — 100元
起司花生培根牛 — 95元
手工鄉村牛肉漢堡 — 90元
起司花生里肌歐姆蛋 — 90元
起司雪花雞 — 85元
起司豬柳排 — 80元
花生里肌蛋 — 80元
花生里肌蛋 — 75元
手工鄉村雞肉漢堡 — 75元
蜂蜜芥末蒜酥雞歐姆蛋 🌿 — 70元
起司火腿歐姆蛋 — 70元
起司鮪魚沙拉 — 70元
起司肉鬆歐姆蛋 — 65元
鮮蔬歐姆蛋 🌿 — 65元
花生歐姆蛋 — 60元
每個項目旁邊都有一個方框,供顧客選擇A、B或C選項。
2. 辨識穿著:
對視障者來說,要了解衣著的顏色及樣式、如何搭配更加合適等都是相對困難的事。此時筆者就會請 AI 描述我手上或穿在身上的衣服顏色及花樣,知道自己穿了什麼顏色的衣服,搭配起來是否合適。甚至有時筆者也會好奇別人的穿著,就會讓 AI 描述照片中人們的穿著,這樣也會讓人感覺與照片中的人更加親近。
3. 辨識週遭場景:
當筆者來到一個陌生的環境,例如教室、車站、別人家裡、等等,會好奇究竟有哪些擺設或裝飾,而顯然無法親自觸摸探索整個環境,此時只要隨手一拍,AI 就可以說出室內有哪些物品,桌椅、櫃子、牆上的擺設、窗外的景物等等。而在室外也是一樣,透過 AI 的描述,讓視障者可以知道外面的天色、有哪些建築物、車輛、店家等等相當有趣。
參考資料:
Be My Eyes Accessibility with GPT-4o
從上述隔壁早餐菜單的實際運用範例中,我們也可以發現,圖像辨識不僅是直接幫助視障者了解圖像內容,更是大大提升視障者的生活自主性。例如過去筆者必須仰賴他人唸菜單來挑選餐點,往往怕別人麻煩而無法讓自己好好挑選美食、慢慢考慮。有了圖像辨識,閱讀菜單完全掌握在自己的手裡,可以更自在的挑選並享受閱讀菜單的樂趣。
在 AI 的輔助下,圖像辨識的能力確實邁進了一大步,筆者也很有感其各式應用帶來的便利,幫助解決生活大小事。但目前 AI 的圖像辨識仍有些不足之處,仍值得我們期待與展望:
- 需要加強辨識的準確和信任度:目前 AI 回傳的辨識結果看似詳細豐富,但難免會遇到辨識不準或無中生有的情況,此時視障者很難分辨是真實出現在畫面中的內容,或是 AI 自行杜撰的。以前述的菜單為例,AI 錯誤的將花醬里肌蛋說成花生里肌蛋。未來若能提高辨識準確度,將有助於增加視障者使用的意願及使用時機。
- 需要提高辨識的速度:目前 AI 辨識一張圖片的速度大約落在 5 至 10 秒,若能夠提高辨識的速度,將能夠大幅地提高使用者體驗,更好地運用到各種場合中。例如協助視障者拍照、需要辨識大量影像時。若能有效降低辨識所需的時間,並提升辨識精確度,甚至有機會更安全地協助視障者外出行動。
- 拓展至影片內容的辨識及描述:或許在不久的將來, AI 輔助影像辨識也能夠取代口述影像的角色,幫助視障者觀看影片,描述影片中的場景及畫面,那將大大有助於視障者領略電影的世界。
圖像辨識技術的發展,為視障者理解周圍世界提供了新的途徑。AI 技術的加入,更使圖像辨識技術邁上了新的台階。筆者相信,隨著 AI 技術的不斷發展,圖像辨識將會更加完善,為視障者帶來更加美好的生活體驗。